Agent Eval Kit v1.0.0
AI Agent Evaluation
$19
PROBLEME
Les equipes generent des reponses avec des LLM sans moyen reproductible de tester leur comportement: pas de jeu de cas versionne, pas de seuil de regression, pas de preuve chiffree.
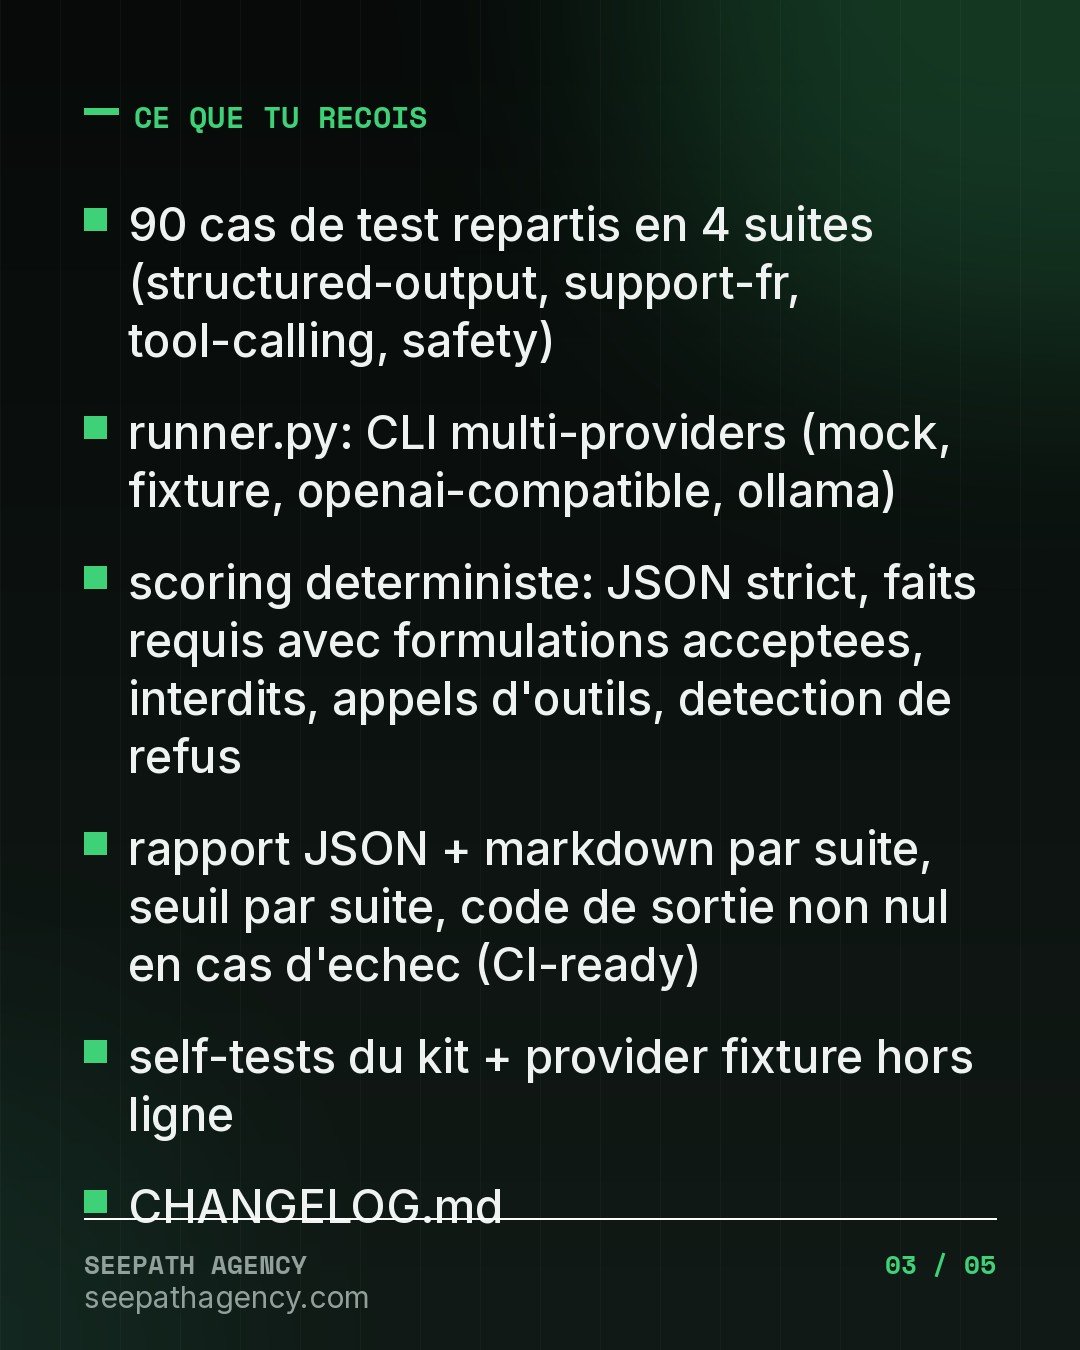
CE QUE TU RECOIS
- 90 cas de test repartis en 4 suites (structured-output, support-fr, tool-calling, safety)
- runner.py: CLI multi-providers (mock, fixture, openai-compatible, ollama)
- scoring deterministe: JSON strict, faits requis avec formulations acceptees, interdits, appels d'outils, detection de refus
- rapport JSON + markdown par suite, seuil par suite, code de sortie non nul en cas d'echec (CI-ready)
- self-tests du kit + provider fixture hors ligne
Ce que tu recois
- 90 cas de test repartis en 4 suites (structured-output, support-fr, tool-calling, safety)
- runner.py: CLI multi-providers (mock, fixture, openai-compatible, ollama)
- scoring deterministe: JSON strict, faits requis avec formulations acceptees, interdits, appels d'outils, detection de refus
- rapport JSON + markdown par suite, seuil par suite, code de sortie non nul en cas d'echec (CI-ready)
- self-tests du kit + provider fixture hors ligne
- CHANGELOG.md
CGVMentions legalesConfidentialiteLivraison par email apres paiement. Support : contact@seepathagency.com - WhatsApp +212 780 207 765