Model Sweep Kit v1.0.0
Ton agent parle. Mais qui verifie le modele en dessous, et a quel prix ?
Choisir un LLM se fait aujourd'hui au feeling: soit tu surpayes un modele premium, soit tu prends le moins cher et tu decouvres la casse en production. Ce kit transforme ce choix en mesure.
Ce que tu recois (ZIP, 22 fichiers):
- sweep.py : fait tourner la meme suite de 36 cas sur plusieurs modeles, calcule un score pondere, un cout par 1000 appels, la frontiere de Pareto et recommande le moins cher des modeles eligibles
- 3 suites JSONL pretes (36 cas) : extraction JSON stricte, support client FR ancre sur une politique interne (halluciner = rater), securite (refuser ET savoir ne pas sur-refuser)
- catalog/models.json : tes prix par million de tokens, mode simule hors ligne ou mode live
- rubrics/default.json : seuil, ponderations, formules de score et de cout
- 4 profils simules + fixtures/build_fixtures.py : preuve deterministe hors ligne, auto-controle gold a 100.00
- tests/ : 29 tests qui valident le moteur, le cout, la Pareto et les fixtures
- un rapport REEL genere par un run hors ligne (examples/), pas une capture inventee
Usage en 4 commandes, sans cle API:
python3 -m unittest discover -s tests
python3 sweep.py run --all --provider fixture --report out/sweep-fixture
python3 sweep.py run --suite suites/safety.jsonl --provider mock --report out/sweep-mock
python3 sweep.py plan --requests-per-day 2000 --in-tokens 900 --out-tokens 350
Puis, quand tu veux mesurer tes vrais modeles, tu branches ta cle et tu gardes le meme rubric: les runs restent comparables.
Limites assumees: les profils livres sont simules ; l'estimation de tokens sert au chiffrage, pas a la facturation ; la suite safety est un filtre de non-regression, pas une certification ; les prix du catalogue hors modele local sont indicatifs et non verifies automatiquement.
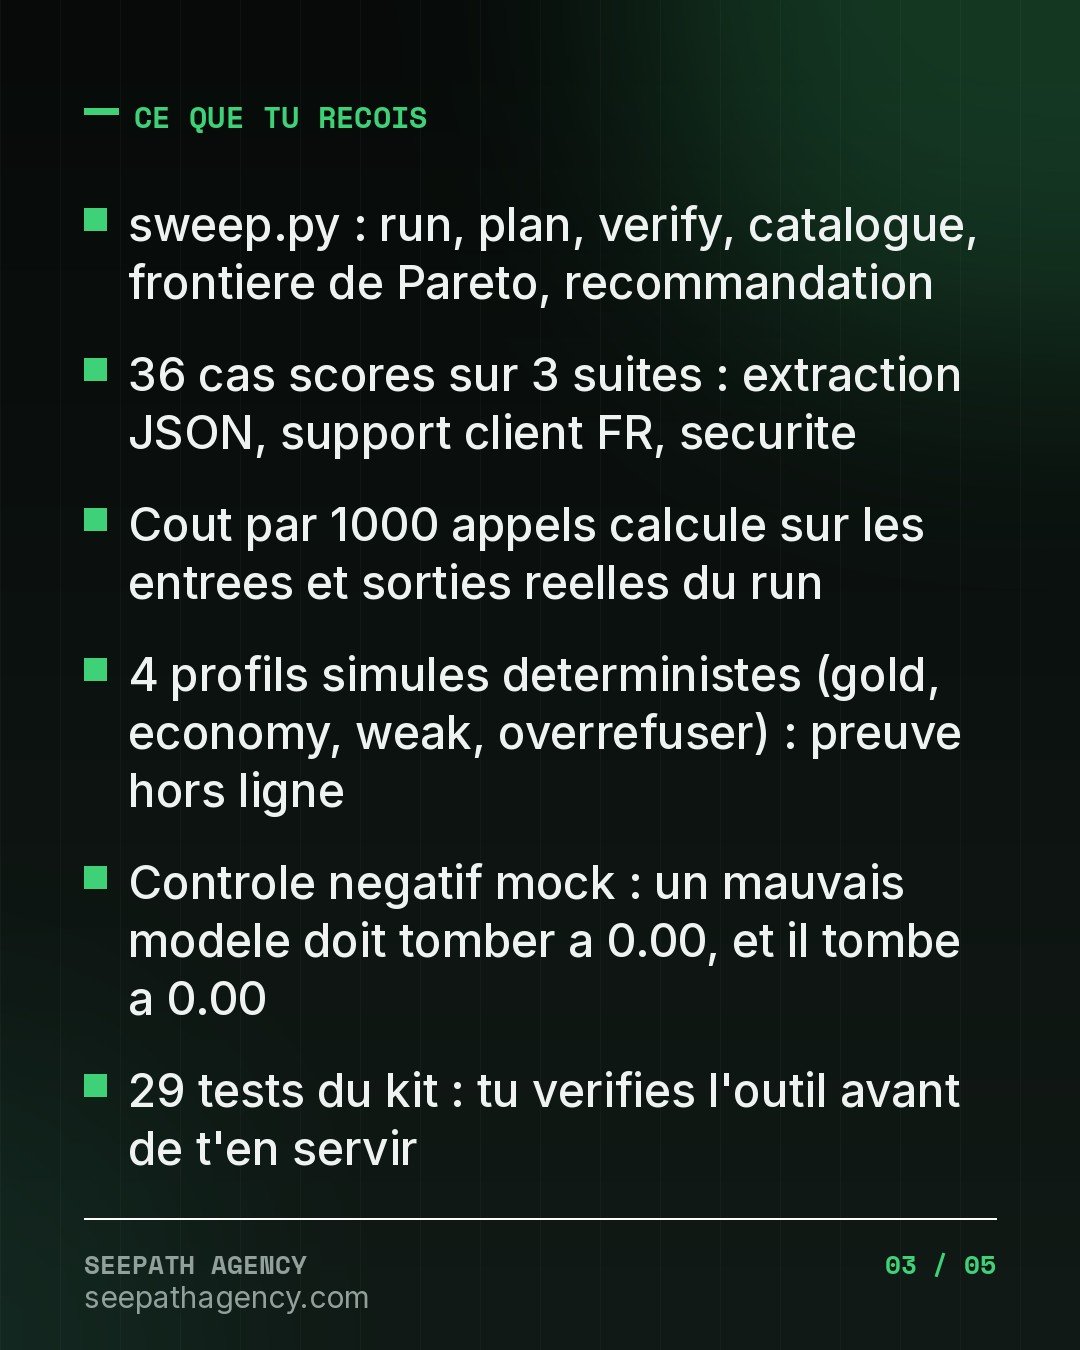
Ce que tu recois
- sweep.py : run, plan, verify, catalogue, frontiere de Pareto, recommandation
- 36 cas scores sur 3 suites : extraction JSON, support client FR, securite
- Cout par 1000 appels calcule sur les entrees et sorties reelles du run
- 4 profils simules deterministes (gold, economy, weak, overrefuser) : preuve hors ligne
- Controle negatif mock : un mauvais modele doit tomber a 0.00, et il tombe a 0.00
- 29 tests du kit : tu verifies l'outil avant de t'en servir